Что такое LLMs.txt и почему он бесполезен для GEO-продвижения
Проверяем, используют ли ИИ-поисковики расхайпленный llms.txt и что показывают логи сервера.
Тема с llms.txt и llms-full.txt давно и активно форсится. Рынок преподносит это как обязательный этап для качественного GEO, агентства продают настройку клиентам, а Тильда даже выкатила под это отдельную кнопку в админке.
Я с командой провел эксперимент: залил файл на сайт, подождал 5 дней, проверил логи веб-сервера и… Спойлер: ИИ-шкам на него плевать)
Что за файл
Черновик стандарта llms.txt предложил в сентябре 2024 года австралийский разработчик Джереми Ховард из Answer.AI. Документацию выложили на llmstxt.org, а проект залили на GitHub.
Логика такая: сайты сейчас забиты тяжелым кодом и скриптами, ИИ-моделям парсить это тяжело и дорого. Чтобы разработчикам было удобно скормить контекст в ИИ-ассистента (по типу Cursor или локальных LLM), автор предложил класть в корень сайта markdown-файл (причем почему-то в формате .txt) с выжимкой и ссылками.
То есть инструмент изначально создавался для разработчиков и ручной передачи контекста, а не как «новый robots.txt для поисковых краулеров».
Но рынок быстро подхватил хайп: агентства решили, что если положить в корень выжимку о компании, то ChatGPT и Perplexity начнут брать факты именно оттуда. При этом ни OpenAI, ни Google, ни Anthropic нигде не заявляли, что их поисковые боты вообще будут поддерживать этот файл.
Эксперимент
Я работаю в компании, которая разрабатывает антибот-защиту — и соответственно мы умеем глубоко смотреть весь трафик. Так что гадать не придётся, т.к у меня есть логи (технические записи о запросах к сайту). Там видно вообще всё: айпишники, юзерагенты (даже если бот его подменяет, умеем точно определять) и прочая техничка.
Что делали:
- Вместе с командой (ПММ и PR) расписали все продукты и позиционирование компании — так, как хотим выглядеть в ответах нейронок.
- Спрятали внутри пасхалку — инфу и «код» несуществующего продукта, которого ещё нет. Логика такая: если ИИ-боты реально ходят в /llms.txt, я просто спрошу в ChatGPT про новый продукт и его «код» — и по ответам сделаю выводы.
- Оформили всё как полагается, поставили ссылку на файл в robots.txt и выкатили на сайт.
Договорились так: если сработает как задумано, то есть нейронки подхватят и будут использовать инфу из этого файла — следом сделаем ещё и большой llms-full.txt.
Что показали логи
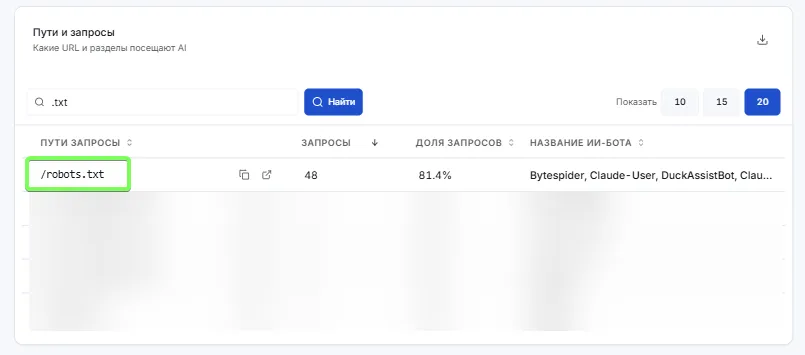
Прошло 5 дней с публикации. Я открываю логи, а там — ровно 0 запросов. За все дни ни одного запроса от ИИ к этому файлу.
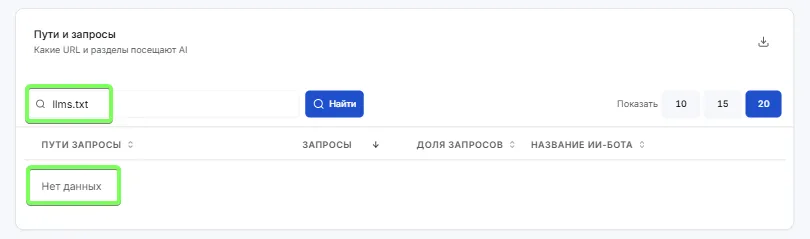
Кстати, в тот же robots.txt боты OpenAI, Anthropic и Perplexity заходят стабильно и соблюдают директивы (правила). То есть на самом сайте боты есть, трафик идет непрерывно, сайт они видят отлично, но этот файл просто проигнорировали.
До проверки зашитой пасхалки в чате с ChatGPT дело даже не дошло — файл тупо никто не открывал. Важно обозначить, что я специально не говорил нейронке о том, что такой файл у нас есть. Иначе какой смысл?)
Что в итоге
Нейросети работают иначе, чем нам пытаются продать. Когда ты задаешь вопрос ChatGPT или Perplexity, модель не идет сканировать корень сайта в поисках какого-то текстовика. Она берет ссылки из поисковой выдачи, переходит по ним и парсит стандартный HTML конкретной страницы.
При этом сами по себе текстовые инструкции для нейросетей вполне работают. В вайб-кодинге используют файлики по типу AGENTS.md. ИИ-агенты читают их, чтобы понимать устройство проекта, правила работы с кодом, дизайн-систему и т. п. Но тут совсем другая история: агент заранее знает, где искать инструкции. К GEO-продвижению это никакого отношения не имеет.
Так, теперь этот llms.txt лежит у нас на сайте мертвым грузом. Хуже от него не будет, но и пользы — ноль. Разве что вы сами ручками скормите прямую ссылку на него в чат с нейронкой, чтобы быстро передать контекст проекта. Но тогда и стандарт, описанный в документации llms.txt, просто не нужен — с тем же успехом можно скинуть ссылку на обычную ссылку на сайт или гугл-док.
Сборку llms-full.txt мы, естественно, отложили. Реальное GEO всё так же держится на понятной SEO-базе (понятной структуре, полезности, оригинальности и релевантности контента) и на технической доступности сайта (о чём можете почитать в этой статье).